1、缓存的收益与成本
-》收益
---》加速读写
通过缓存加速读写速度:cup L1/L2/L3 Cache、Linux page Cache加速硬盘读写、浏览器缓存、Ehcache缓存数据库结果
---》降低后端负载
后端服务器通过前端缓存降低负载:业务端使用redis降低后端MySQL负载等
-》成本
---》数据不一致:缓存层和数据层有时间窗口不一致,和更新策略有关
---》代码维护成本:多了一层缓存逻辑
---》运维成本:例如redis cluster
-》使用场景
---》降低后端负载:对高消耗的sql:join结果集/分组统计结果缓存
---》加速请求响应:利用redis/memcache优化IO响应时间
---》大量写合并为批量写:如计算器先redis累加再批量写DB
2、缓存更新策略
-》LRU/LFU/FIFO算法剔除:例如maxmemory-policy 控制最大内存
-》超时剔除:例如expire
-》主动更新:开发控制生命周期
3、缓存粒度控制
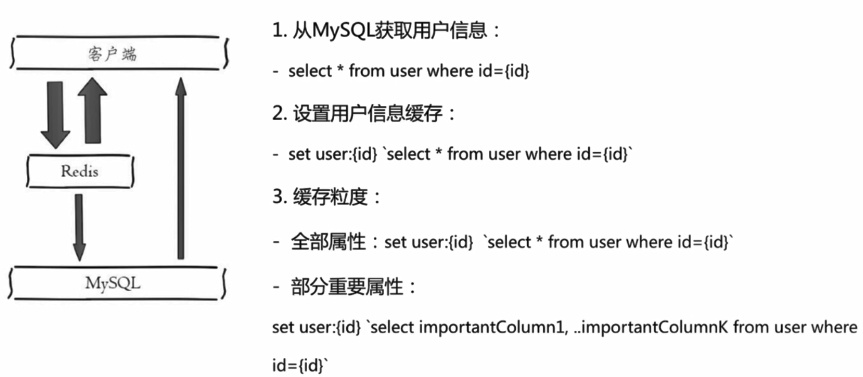
-》通用性:全量属性更好
-》占用空间:部分属性更好
-》代码维护:表面上全量属性更好
通俗的说就是要缓存多少数据,是缓存所有表字段和是只缓存部分表字段
4、缓存穿透
-》大量请求不命中
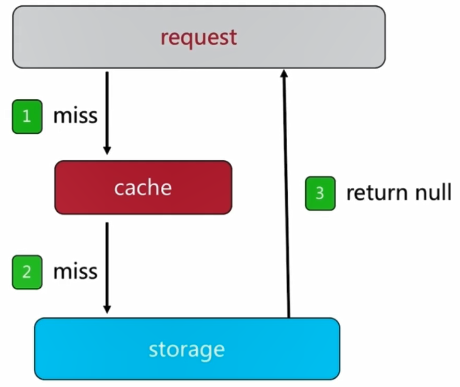
如果出现这种情况的话,那么缓存就没有任何作用,请求还是会一直穿透到存储层(DB数据库)
产生这种情况的原因:
---》业务代码自身问题
---》恶意攻击、爬虫等等
如何发现这种情况:
---》业务的响应时间
---》业务本身问题
---》相关指标:总调用数、缓存层命中数、存储层命中数
-》解决缓存空对象
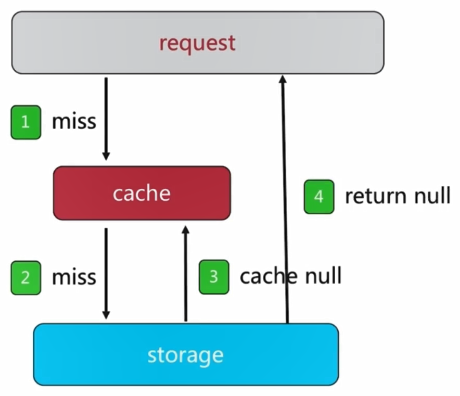
这总解决方法就是将null的值也缓存再cache中然后设置一个过期时间,当到达过期时间时再去更新缓存cache
这种解决会产生的问题:
---》需要更多的键
---》缓存层和存储层数据”短期“不一致
-》解决缓存穿透:布隆过滤器拦截
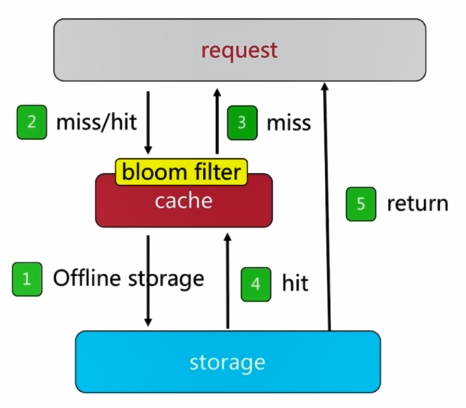
5、无底洞问题
加机器性能反而下降,就是节点越多时,性能越低了
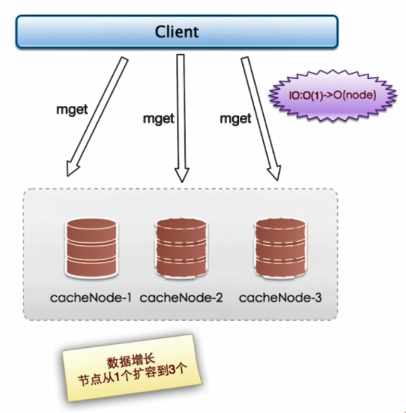
问题关键点:
更多的机器!=更高的性能
批量接口需求(mget、mset等)
数据增长与水平扩展需求
优化IO的几种方法
---》命令本身优化:例如慢查询keys、hgetall bigkey
---》减少网络通信次数
---》降低接入成本:例如客户端长连接/连接池、NIO等
6、热点key的重建优化
问题描述:热点key+较长的重建时间
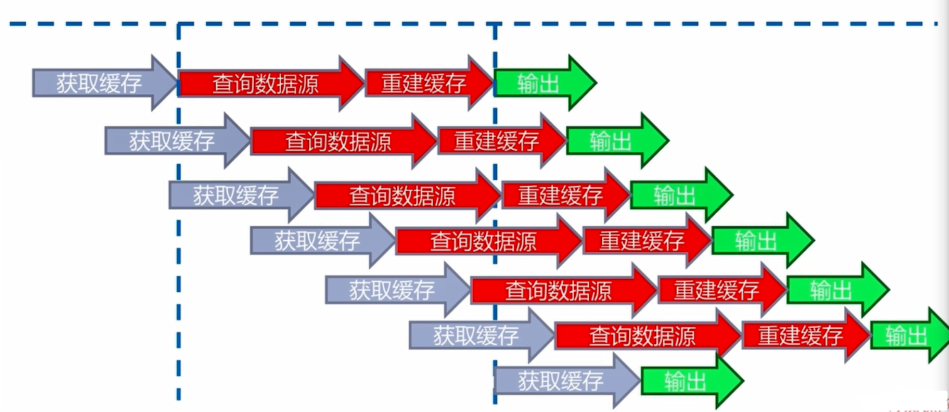
解决方法和目的
1、三个目的
----》减少缓存的次数
----》数据尽可能一致
----》减少潜在危险
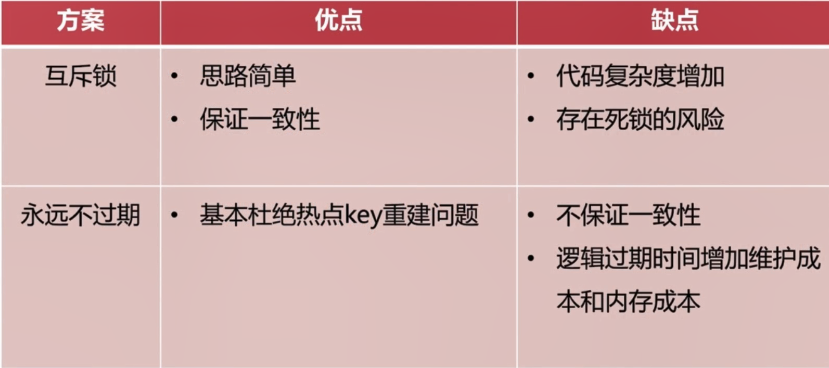
2、两个解决
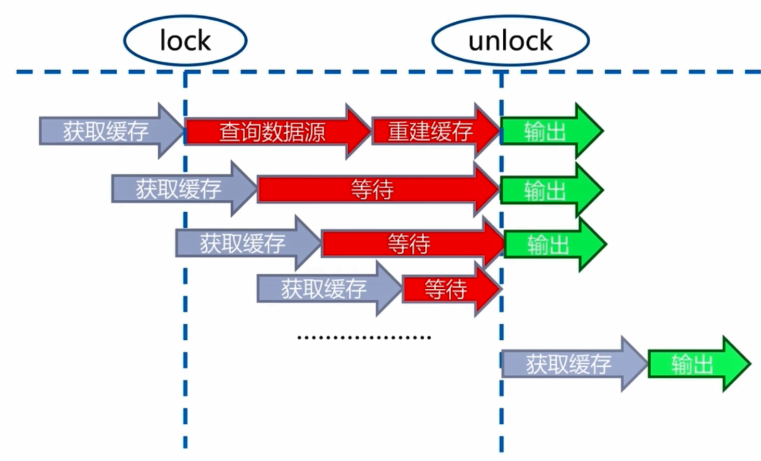
----》互斥锁(mutex key)
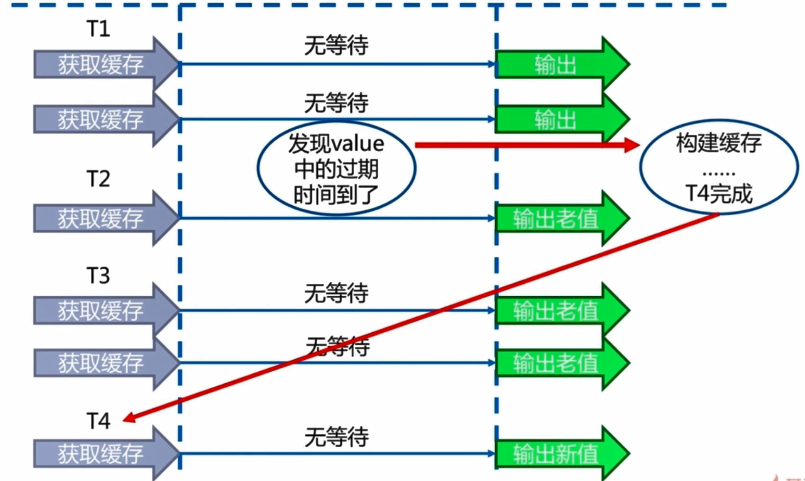
----》永远不过期
a、缓存层面:没有设置过期时间(没有用expire)
b、功能层面:为每个value添加逻辑过期时间,但发现超过逻辑过期时间后,会使用单独的线程去构建缓存