redis cluster 分布式集群之一(集群介绍和几种分区说明)
呼唤集群
为什么呼唤集群
1、并发量,2、数据量,3、网络流量
数据分布
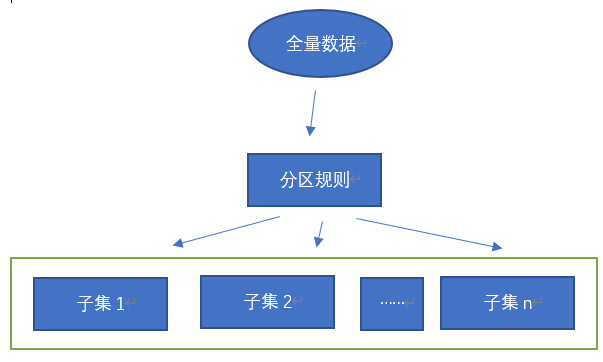
1、顺序分区
特点:数据分散度易倾斜、键值业务相关、可顺序访问
数据分散度易倾斜是指例如早期的数据访问度会更高
2、哈希分区(节点取模)
特点:数据分散度高、键值分布业务无关、无法顺序访问、支持批量操作
哈希分布有可以分为
a、节点取余分区
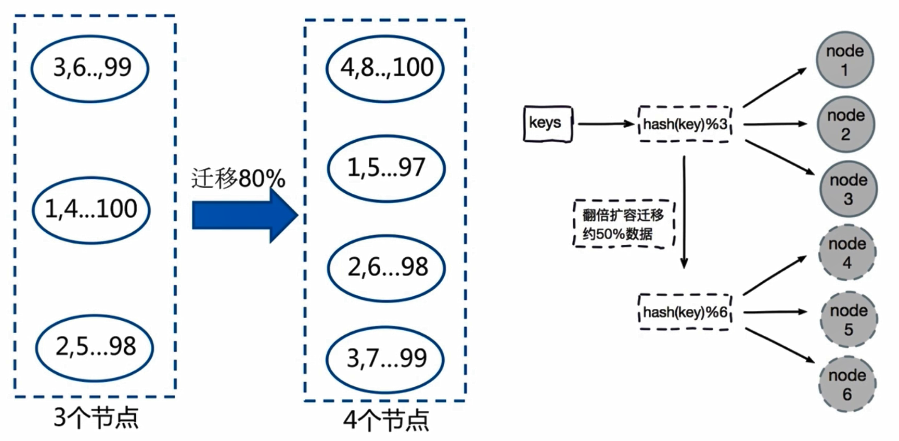
这种分区增加节点会把原来的分区遍历去与总分区数量取余,再重新分区
例如:原先是3个分区是hash(key)%3,现在加一个分区的话就变成了hash1(key)%4,hash2(key)%4,hash3(key)%4,这些值的取余再重新分配到4个分区中。
建议:使用翻倍扩容,即原来是3个分区,现在扩容就可以是6个分区,这样增加扩容可以减少扩容迁移的数据量。
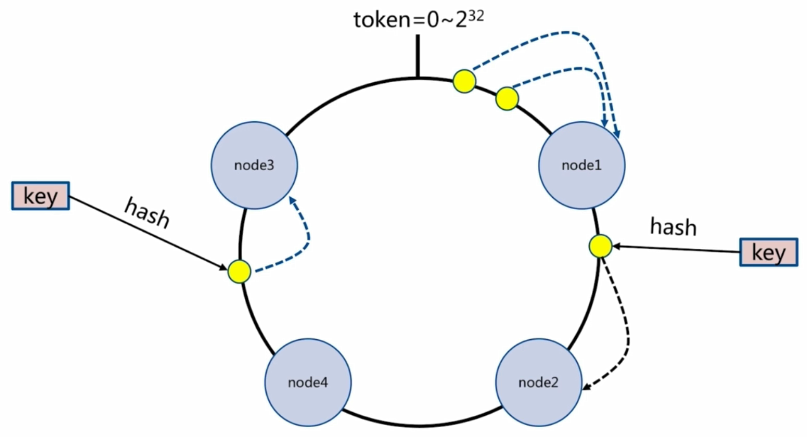
b、一致性哈希分区
客户端分片:哈希+顺时针(优化取余)
节点伸缩:只影响节点,但是还是有数据迁移
翻倍伸缩:保证最小迁移数据和负载均衡
c、虚拟槽分区
预设虚拟槽:每个槽映射一个数据子集,一般比节点数大
良好的哈希函数:例如CRC16
服务端管理节点:槽、数据、:例如redis cluster
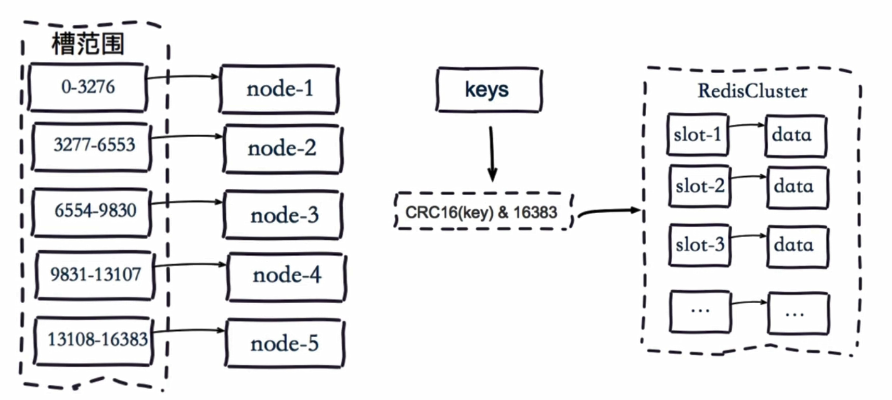
分布式架构
说明:节点之间是相互通信的
redis cluster结构
1、节点 cluster-enabled:yes(是不是一个集群模式,yes是集群)
2、meet 连接槽的基础,所有节点共享信息
3、指派槽 redis默认有16384个槽(slot)
a、keyhash = hash(key) b、slot = keyhash%16384
4、复制
redis cluster 特性
1、复制
2、高可用
3、分片