sentinel的三个定时任务
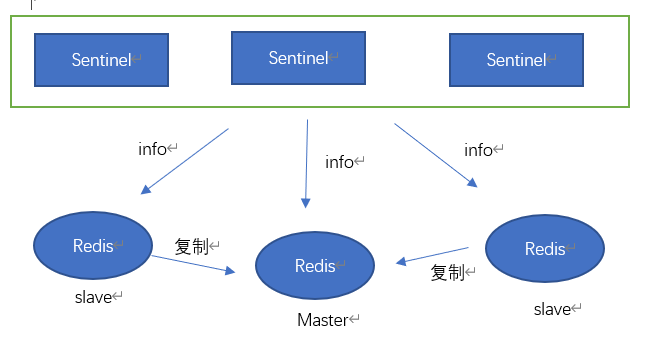
1、每10秒每个sentinel对master和slave执行info(info记录了redis的主从节点的信息)
a、发现slave节点
b、确认主从关系
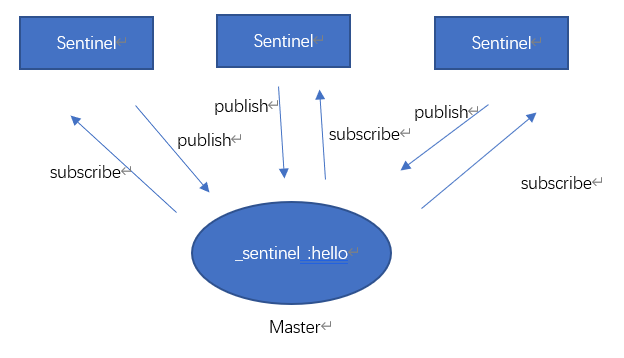
2、每2秒每个sentinel通过master节点的channel交换信息
a、通过_sentinel_:hello频道交互
b、交互对节点的”看法“和自身信息
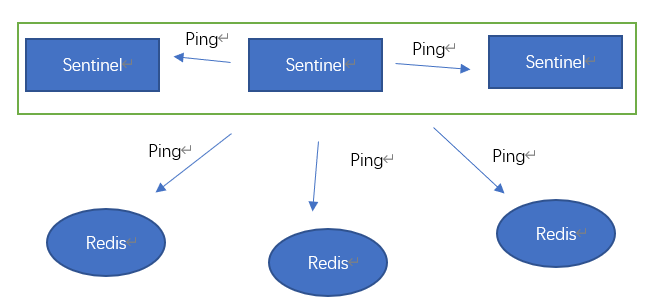
3、每1秒每个sentinel对其它sentinel和redis执行ping
a、心跳检测,失败判定依据
主观下线和客观下线
主观下线:每个sentinel节点对redis节点失败的”偏见“
客观下线:所有的sentinel节点对redis节点失败”达成共识“(大于等于quorum个统一)
sentinel配置项:sentinel monitor mymaster 127.0.0.1 6379 2(这项配置中的2就是quorum)
sentinel通过is-master-down-by-addr命令来询问其它的sentinel是否也认为master有问题,如果有quorum个sentinel认为有问题,这时就达成了客观下线的条件了。
说明:slave是没有客观下线的,因为它不需要做故障转移,只要主观下线就可以了。
领导者选举
原因:只有一个sentinel节点完成故障转移
选举:通过sentinel is-master-down-by-addr命令来进行sentinel之间的询问,因为每个sentinel都希望成为领导者
1、每个做主观下线的sentinel节点向其它sentinel节点发送命令,需要将它设置为领导者
2、收到命令的sentinel节点如果没有同意通过其它sentinel节点发送的命令,那么将同意该请求,否则拒绝
3、如果该sentinel节点发现自己的票数已经超过sentinel集合半数且超过quorum,那么它将成为领导者
4、如果此过程有多个sentinel节点成为领导者,那么将等待一段时间重新进行选举
故障转移
1、从slave节点中选出一个“合适的”节点作为新的master节点
2、对上面的slave节点执行slave执行slave no one 命令,让其成为master节点
3、向剩余的slave节点发送命令,让它们成为新master系欸但的slave节点
复制规则和parallel-syncs参数有关
parallel-syncs解释:如果设置为1的话,那么slave需要按顺序复制master,如果设置为2,则是所有slave同时接受master的RDB文件进行复制,这样对master节点的网络压力会比较大
4、更新对原来master节点配置为slave,并保持对其“关注”,当其恢复后命令它去复制新master节点
特点注意:选择“合适的”slave节点
1、选择slave-priority(slave节点优先级)最高的slave节点,如果存在则返回,不存在则继续
2、选择复制偏移量最大的slave节点(复制的最完整),如果存在则返回,不存在则继续
3、选择runId最小的slave节点(也就是最早的节点)
节点运维
1、节点下线和上线
a、主节点
b、从节点
c、sentinel节点
说明:什么情况要下线
a、机器下线:如机器年代过久,过了保质期不能再用了
b、机器性能不足:cup,内存,硬盘,网络等
c、节点自身故障:服务器不稳定
主节点下线
sentinel failover master名称
说明:手动完成故障转移减少了主观下线,客观领导者选举的过程,直接执行故障转移了
从节点下线
临时下线还是永久下线,例如是否做一些清理工作,但是要考虑读写分离的情况
sentinel节点下线和从节点是一样的
节点上线
主节点:sentinel failover 进行替换
从节点:slaveof即可,sentinel节点可以感知
sentinel节点:参考其它sentinel节点启动即可
从节点的作用
1、副本:高可用的基础
2、扩展:读能力
从节点的监控需要自己监控,可以通过一下三个“消息”进行监测
a、+swith-master:切换主节点(从节点晋升为主节点)
b、+convert-to-slave:切换从节点(原主节点降为从节点)
c、+down:主观下线