切换导航
简历
工具
演示
查询
导航菜单
服务端
30
前端
114
数据库
82
进阶开发
8
桌面程序
2
QA
15
软件使用
36
规范协议
5
操作系统
11
AI
0
复用资源
6
硬件
0
标签
SQL Server
Redis
MySQL
其它
Oracle
外部链接
.NET Core SDK和运行时安装包
淘宝 NPM 镜像
查询网
Tables Generator线上表格转换工具
引用cdn在线脚本和样式
首页
数据库
MySQL 数据库的事务使用
[TOC] # 1. MySQL 事务 事务【transaction】:一些列要发生的连续的操作,它是一个工作单元 ## 1.1 事务安全 一种保护连续操作同时实现的一种机制,它的意义是保证了数据操作的完整性 ## 1.2 事务原理 事务开启之后,所有的操作都会临时保存到事务日志,事务日志只有在得到commit命令才会同步到数据表,其他任何情况都会清空,这里的任何情况包括 rollback、服务器断电、断开服务器连接 ## 1.3 事务操作 ### 1.3.1. 手动事务 __操作流程:__ + 开启事务:告知系统以下所有的写操作不要直接写入到数据表,先存放到事务日志 - 开启事务指令:<mark>start transaction;</mark> + 事务操作:一系列连续的操作,操作里面包含 insert、update、delete 这些写操作 - 这时数据并未写入到表中,虽然这时select查看发现表数据变化了(这是事务日志呈现的一个结果),但切换其它客户端查看就会发现表数据并未真的被修改 + 关闭事务:选择性的将日志文件中操作的结果保存到数据表并清空日志文件,或清直接空事务日志,清除事务流程中的操作,它们对应了结束事务的两种方式 - 提交事务:同步数据表,操作成功,提交指令<mark>commit;</mark> - 回滚事务:直接清空日志表,操作失败,回滚指令<mark>rollback;</mark> ```SQL -- 开始事务 start transaction; -- 事务操作1,插入学生数据 insert into my_student (birthday,name,gender,height,age,nation) values('1985-10-02','马超','男',1.83,46,'汉'); -- 事务操作2,插入学生班级关联数据 insert into my_studentClasssRelation (classs,level,student) select my_classs.id, my_classs.level,(select id from my_student where name='马超') student from my_classs where my_classs.name = '1班'; -- 提交事务 commit; -- 回滚事务(代码执行异常可以回滚,使用 try catch,正常使用 commit,异常使用 rollback) -- rollback; ``` #### 1.3.1.1 回滚点 在某个成功的操作完成之后,后续的操作有可能成功有可能失败,但是不管成功还是失败,前面操作都已经成功,可以在当前成功的位置,设置一个点,可以供后续失败操作返回到该位置,而不是返回所有操作,这个点就叫做回滚点 __设置回滚点语法:__<mark>savepoint 回滚点名字;</mark> __回到回滚点语法:__<mark>rollback to 回滚点名字;</mark> ```SQL -- 开始事务 start transaction; -- 事务操作1,插入学生数据 insert into my_student (birthday,name,gender,height,age,nation) values('1983-09-02','魏延','男',1.86,50,'汉'); -- 设置回滚点 savepoint sp; -- 事务操作2,插入学生班级关联数据 insert into my_studentClasssRelation (classs,level,student) select my_classs.id, my_classs.level,(select id from my_student where name='魏延') student from my_classs where my_classs.name = '1班'; -- 验证数据,学生班级关联是否正确,这里设定发现错误,魏延本应该是去2班的,这时就可以回滚到回滚点,然后重新插入学生班级关联即可 select * from my_studentClasssRelation -- 回滚到回滚点,即成功插入了学生信息的位置 rollback to sp -- 事务操作3,重新给学生关联数据 insert into my_studentClasssRelation (classs,level,student) select my_classs.id, my_classs.level,(select id from my_student where name='魏延') student from my_classs where my_classs.name = '2班'; -- 提交事务 commit; ``` ### 1.3.2. 自动事务 在 MySQL 中默认的都是自动事务处理,用户操作完会立即同步到数据表中,系统通过 `autocommit` 变量控制自动事务 ```SQL -- 查看自动事务变量 show variables like 'autocommit' +---------------+-------+ | Variable_name | Value | +---------------+-------+ | autocommit | ON | +---------------+-------+ -- 还可以通过下面的命令查询自动提交命令是否开启,1表示开启了 select @@autocommit; +--------------+ | @@autocommit | +--------------+ | 1 | +--------------+ -- 关闭自动事务,值可以是0,也可以是off set autocommit = 0; +---------------+-------+ | Variable_name | Value | +---------------+-------+ | autocommit | OFF | +---------------+-------+ -- 关闭自动事务后,再执行写操作,需要手动的提交事务,如果下面的更新语句后面没有跟随commit,这条数据更新是不会成功的 update my_student set age = 55 where name = '马超'; commit; ``` > 不要随意的修改自动事务,关闭自动事务,会造成许多不必要的commit操作,而且容易遗忘,造成不必要的bug ## 1.4 事务特性 事务有四大特性:ACID + A:Atomic 原子性,事务的整个操作是一个整体,不可分隔,要么全部成功,要么全部失败 + C:Consistency 一致性,事务操作的前后,数据表中的数据没有变化 + I:Isolation 隔离性,事务操作是相互隔离不受影响的,客户端同时开始自己的事务,它们之间不会相互影响 + D:Durability 永久性,数据一旦提交,不可改变,永久的改变数据表数据 __锁机制:__innodb默认是行锁,但是如果在事务操作的过程中,没有使用到索引,那么系统会自动全表检索数据,自动升级为表锁 + 行锁:只有当前行被锁住,别的用户不能操作 + 表锁:整张表被锁住,别的用户都不能操作 ### 1.4.1. 原子性 ### 1.4.2. 一致性 ### 1.4.3. 隔离性 当数据库上有多个事务同时执行的时候,就可能出现脏读(dirty read)、不可重复读(non-repeatable read)、幻读(phantom read)的问题,为了解决这些问题,就有了“隔离级别”的概念 > 数据库并发事务产生的三大问题 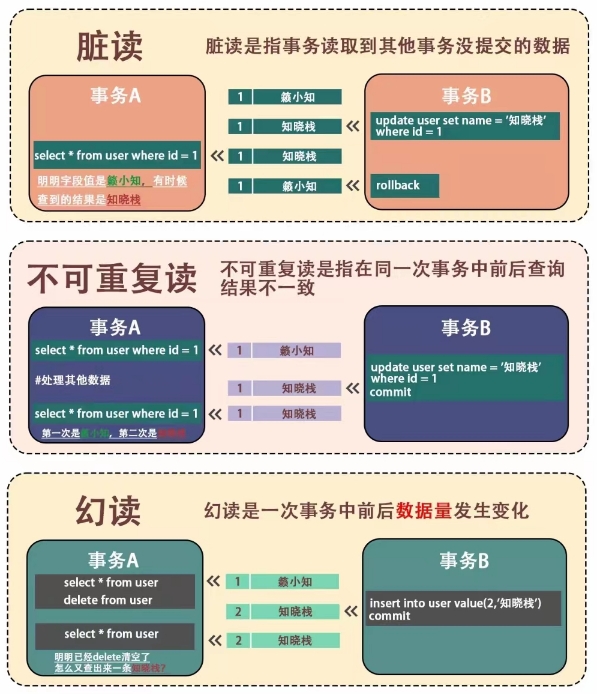 #### 1.4.3.1. 隔离性与隔离级别 在谈隔离级别之前,你首先要知道,你隔离得越严实,效率就会越低。因此很多时候,我们都要在二者之间寻找一个平衡点。SQL 标准的事务隔离级别包括:读未提交(readuncommitted)、读提交(read committed)、可重复读(repeatable read)和串行化(serializable )。下面我逐一为你解释: + 读未提交是指,一个事务还没提交时,它做的变更就能被别的事务看到。 + 读提交是指,一个事务提交之后,它做的变更才会被其他事务看到。 + 可重复读是指,一个事务执行过程中看到的数据,总是跟这个事务在启动时看到的数据是一致的。当然在可重复读隔离级别下,未提交变更对其他事务也是不可见的。 + 串行化,顾名思义是对于同一行记录,“写”会加“写锁”,“读”会加“读锁”。当出现读写锁冲突的时候,后访问的事务必须等前一个事务执行完成,才能继续执行。 > 其中“读提交”和“可重复读”比较难理解,所以用一个例子说明这几种隔离级别。假设数据表 T 中只有一列,其中一行的值为 1,下面是按照时间顺序执行两个事务的行为。 > ```SQL create table T(c int) engine=InnoDB; insert into T(c) values(1); ``` > 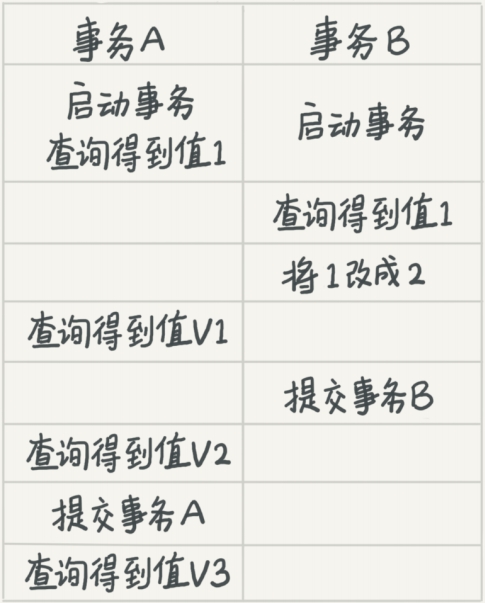 > 我们来看看在不同的隔离级别下,事务 A 会有哪些不同的返回结果,也就是图里面 V1、V2、V3 的返回值分别是什么。 > 若隔离级别是“读未提交”, 则 V1 的值就是 2。这时候事务 B 虽然还没有提交,但是结果已经被 A 看到了。因此,V2、V3 也都是 2。 > 若隔离级别是“读提交”,则 V1 是 1,V2 的值是 2。事务 B 的更新在提交后才能被 A看到。所以, V3 的值也是 2。 > 若隔离级别是“可重复读”,则 V1、V2 是 1,V3 是 2。之所以 V2 还是 1,遵循的就是这个要求:事务在执行期间看到的数据前后必须是一致的。 > 若隔离级别是“串行化”,则在事务 B 执行“将 1 改成 2”的时候,会被锁住。直到事务 A 提交后,事务 B 才可以继续执行。所以从 A 的角度看, V1、V2 值是 1,V3 的值是 2。 在实现上,数据库里面会创建一个视图,访问的时候以视图的逻辑结果为准。在“可重复读”隔离级别下,这个视图是在事务启动时创建的,整个事务存在期间都用这个视图。 在“读提交”隔离级别下,这个视图是在每个 SQL 语句开始执行的时候创建的。这里需要注意的是,“读未提交”隔离级别下直接返回记录上的最新值,没有视图概念;而“串行化”隔离级别下直接用加锁的方式来避免并行访问。 *** 我们可以看到在不同的隔离级别下,数据库行为是有所不同的。Oracle 数据库的默认隔离级别其实就是“读提交”,因此对于一些从 Oracle 迁移到 MySQL 的应用,为保证数据库隔离级别的一致,你一定要记得将 MySQL 的隔离级别设置为“读提交”。 配置的方式是,将启动参数 transaction-isolation 的值设置成 READ-COMMITTED。你可以用 show variables 来查看当前的值。 ```bash mysql> show variables like 'transaction_isolation'; +-----------------------+----------------+ | Variable_name | Value | +-----------------------+----------------+ | transaction_isolation | READ-COMMITTED | +-----------------------+----------------+ ``` *** 总结来说,存在即合理,哪个隔离级别都有它自己的使用场景,你要根据自己的业务情况来定。我想你可能会问那什么时候需要“可重复读”的场景呢?我们来看一个数据校对逻辑的案例。 假设你在管理一个个人银行账户表。一个表存了每个月月底的余额,一个表存了账单明细。这时候你要做数据校对,也就是判断上个月的余额和当前余额的差额,是否与本月的账单明细一致。你一定希望在校对过程中,即使有用户发生了一笔新的交易,也不影响你的校对结果。 这时候使用“可重复读”隔离级别就很方便。事务启动时的视图可以认为是静态的,不受其他事务更新的影响。 #### 1.4.3.2. 事务隔离的实现 理解了事务的隔离级别,我们再来看看事务隔离具体是怎么实现的。这里我们展开说明“可重复读”。 在 MySQL 中,实际上每条记录在更新的时候都会同时记录一条回滚操作。记录上的最新值,通过回滚操作,都可以得到前一个状态的值。 假设一个值从 1 被按顺序改成了 2、3、4,在回滚日志里面就会有类似下面的记录。 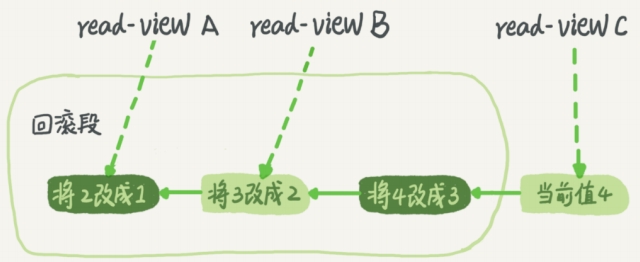 当前值是 4,但是在查询这条记录的时候,不同时刻启动的事务会有不同的 read-view。如图中看到的,在视图 A、B、C 里面,这一个记录的值分别是 1、2、4,同一条记录在系统中可以存在多个版本,就是数据库的多版本并发控制(MVCC)。对于 read-viewA,要得到 1,就必须将当前值依次执行图中所有的回滚操作得到。 同时你会发现,即使现在有另外一个事务正在将 4 改成 5,这个事务跟 read-view A、B、C 对应的事务是不会冲突的。 你一定会问,回滚日志总不能一直保留吧,什么时候删除呢?答案是,在不需要的时候才删除。也就是说,系统会判断,当没有事务再需要用到这些回滚日志时,回滚日志会被删除。 什么时候才不需要了呢?就是当系统里没有比这个回滚日志更早的 read-view 的时候。 基于上面的说明,我们来讨论一下为什么建议你尽量不要使用长事务。 长事务意味着系统里面会存在很老的事务视图。由于这些事务随时可能访问数据库里面的任何数据,所以这个事务提交之前,数据库里面它可能用到的回滚记录都必须保留,这就会导致大量占用存储空间。 在 MySQL 5.5 及以前的版本,回滚日志是跟数据字典一起放在 ibdata 文件里的,即使长事务最终提交,回滚段被清理,文件也不会变小。例如数据只有 20GB,而回滚段有200GB 的库。最终只好为了清理回滚段,重建整个库。 除了对回滚段的影响,长事务还占用锁资源,也可能拖垮整个库,这个我们会在后面讲锁的时候展开。 #### 1.4.3.3. 事务的启动方式 如前面所述,长事务有这些潜在风险,我当然是建议你尽量避免。其实很多时候业务开发同学并不是有意使用长事务,通常是由于误用所致。MySQL 的事务启动方式有以下几种: + 显式启动事务语句, begin 或 start transaction。配套的提交语句是 commit,回滚语句是 rollback + set autocommit=0,这个命令会将这个线程的自动提交关掉。意味着如果你只执行一个 select 语句,这个事务就启动了,而且并不会自动提交。这个事务持续存在直到你主动执行 commit 或 rollback 语句,或者断开连接 有些客户端连接框架会默认连接成功后先执行一个 set autocommit=0 的命令。这就导致接下来的查询都在事务中,如果是长连接,就导致了意外的长事务。 因此,我会建议你总是使用 set autocommit=1, 通过显式语句的方式来启动事务。 但是有的开发同学会纠结“多一次交互”的问题。对于一个需要频繁使用事务的业务,第二种方式每个事务在开始时都不需要主动执行一次 “begin”,减少了语句的交互次数。如果你也有这个顾虑,我建议你使用 commit work and chain 语法。 在 autocommit 为 1 的情况下,用 begin 显式启动的事务,如果执行 commit 则提交事务。如果执行 commit work and chain,则是提交事务并自动启动下一个事务,这样也省去了再次执行 begin 语句的开销。同时带来的好处是从程序开发的角度明确地知道每个语句是否处于事务中。 你可以在 information_schema 库的 innodb_trx 这个表中查询长事务 ### 1.4.4. 永久性
扫一扫手机看
点击排行
windows 文件资源管理器使用
Layui 弹窗open使用说明
SQL Server 中字符串函数使用
C# 使用QQ邮箱代理做邮件接收功能
SQL Server关于apply的两种形式cross apply 和 outer apply
ASP.NET MVC 模型的自定义验证
nvm安装及常用命令
SQL Server 中数据类型转换
SQL Server 中WITH AS短语的使用
IE浏览器下AJAX缓存问题导致数据不更新的解决办法
订阅号