切换导航
简历
工具
演示
查询
导航菜单
服务端
30
前端
114
数据库
82
进阶开发
8
桌面程序
2
QA
15
软件使用
36
规范协议
5
操作系统
11
AI
0
复用资源
6
硬件
0
标签
SQL Server
Redis
MySQL
其它
Oracle
外部链接
.NET Core SDK和运行时安装包
淘宝 NPM 镜像
查询网
Tables Generator线上表格转换工具
引用cdn在线脚本和样式
首页
数据库
MySQL 数据库的结构操作之索引介绍
[TOC] ## 1. 索引介绍 系统根据某种算法,将已有的数据或未来可能新增的数据,单独建立一个文件,文件能够实现快速的匹配数据,并且能够快速的找到对应表中的记录。 一句话简单来说,索引的出现其实就是为了提高数据查询的效率,就像书的目录一样。一本 500 页的书,如果你想快速找到其中的某一个知识点,在不借助目录的情况下,那我估计你可得找一会儿。同样,对于数据库的表而言,索引其实就是它的“目录”。 ### 1.1. 索引的意义 + 提升查询数据的效率 + 约束数据的有效性,例如唯一性等 ### 1.2. 什么时候添加索引 + 某个字段需要作为查询条件并且经常使用到,可以使用索引 + 某个字段需要进行数据的有效性约束,可以使用索引,例如主键和唯一键 ### 1.3. 添加索引带来的问题 索引本身会产生索引文件,而且索引文件可能比数据文件还大,会消耗磁盘空间 [========] ## 2. MySQL中索引种类 ### 2.1. 索引分类概述 在数据库中,索引主要分为聚簇索引和非聚簇索引。聚簇索引决定了数据在磁盘上的物理存储顺序,而一个表只能有一个聚簇索引;非聚簇索引不影响数据的物理存储顺序,一个表可以有多个非聚簇索引。同时,索引也常被分为一级索引(主键索引)和二级索引(辅助索引)。一级索引通常就是聚簇索引,二级索引则是除主键索引之外的其他索引。 ### 2.2. 聚簇索引 聚簇索引可以理解为一种特殊的索引方式,它会把数据和索引放在一起存储,并且按照索引列的值来排列数据在磁盘上的存储顺序。 就好像有一个大书架,书架上的书是按照某种特定的顺序摆放的,比如按照书名的首字母顺序。这个顺序就是聚簇索引的顺序,而书的内容就是我们存储的数据。这样一来,当我们根据这个索引列(书名首字母)去查找书的时候,就能很快地找到,因为数据是按照这个顺序紧密排列在一起的。而且,通过这个索引,我们不仅能快速找到索引列对应的信息,还能直接获取到与这本书相关的其他所有信息,也就是整行数据。在MySQL里,通常主键会被作为聚簇索引,这样可以让数据的存储和查询都更加高效。 #### 2.2.1. 选择聚簇索引的规则 在 MySQL 的 InnoDB 存储引擎中,如果表没有显式定义聚簇索引,它会按以下规则处理并默认定义一个隐式字段作为聚簇索引字段,下面是选择聚簇索引的规则介绍 InnoDB 存储引擎会按照以下优先级来确定聚簇索引: **1、主键作为聚簇索引**:若表中定义了主键,InnoDB 会自动将该主键作为聚簇索引。例如: ```sql CREATE TABLE users ( user_id INT PRIMARY KEY, username VARCHAR(50), email VARCHAR(100) ); ``` 在这个`users`表中,`user_id`列被定义为主键,InnoDB 会使用`user_id`列构建聚簇索引,表中的数据行将按照`user_id`的值顺序存储在磁盘上。 **2、唯一索引作为聚簇索引**:若表中没有定义主键,但存在唯一索引,且该唯一索引的所有列都不为`NULL`,InnoDB 会选择第一个这样的唯一索引作为聚簇索引。例如: ```sql CREATE TABLE products ( product_code VARCHAR(10) UNIQUE NOT NULL, product_name VARCHAR(50) ); ``` 在`products`表中,由于没有定义主键,且`product_code`列是唯一且非空的,InnoDB 会将`product_code`列的唯一索引作为聚簇索引。 **3、隐式的聚簇索引**:若表中既没有主键,也没有合适的唯一索引(所有列都不为`NULL`的唯一索引),InnoDB 会自动创建一个名为`GEN_CLUST_INDEX`的隐式的聚簇索引。这个隐式的聚簇索引使用一个 6 字节的递增值作为索引键,该值由 InnoDB 自动生成和维护。 #### 2.3.2. 隐式聚簇索引的影响 虽然 InnoDB 会自动创建隐式的聚簇索引来确保数据的有序存储和高效访问,但这种方式存在一些潜在的问题: - **性能问题**:由于隐式的聚簇索引键是自动生成的,与业务逻辑无关,在进行数据查询时,很难利用这个隐式索引进行高效的过滤和排序。例如,在进行基于业务字段的范围查询时,无法充分发挥聚簇索引的优势。 - **数据插入效率**:因为隐式的聚簇索引键是递增的,在高并发插入场景下,可能会导致插入操作集中在索引的尾部,从而引起磁盘 I/O 竞争,影响插入性能。 综上所述,在设计数据库表时,建议显式定义主键,以充分利用聚簇索引的优势,提高数据库的性能和数据管理效率。 ### 2.3. 非聚簇索引 非聚簇索引就像是一本独立的目录,它和数据本身是分开存放的。 假设你有一个图书馆,图书馆里的书(数据)是按照某种顺序(比如按照书架编号和层数)摆放的,这就相当于数据原本的存储顺序。而非聚簇索引就像是另外一本单独的索引册,里面记录了一些关键信息(比如书名、作者等)以及这些信息对应的书在图书馆中的位置(类似于数据的物理地址或主键值)。当你要找某本书时,可以先通过这本索引册快速找到你想要的书名或作者等信息,然后根据索引册中记录的位置去图书馆书架上找到对应的书。所以非聚簇索引不影响数据原本的存储顺序,只是提供了一种快速查找数据的方式,就像一个辅助工具一样,帮助你更高效地从大量数据中定位到你需要的内容。 ### 2.4. 主键索引:primary key 主键索引通常就是聚簇索引,但聚簇索引不一定是主键索引,在MySQL的 InnoDB 存储引擎中,在表中可以没有主键索引但一定会有聚簇索引 ### 2.5. 唯一索引:unique key ### 2.6. 全文索引:fulltext index - 针对文章内部的关键字进行索引,全局索引存在的问题是如何确定关键字。英文全局索引要比中文的容易,因为英文单词之间有空格,而中文没有,且中文可以随意组合 ### 2.7. 普通索引:index ### 2.8. 唯一索引与二级索引的关系 #### 2.8.1. 非主键的唯一索引是二级索引 如果唯一索引不是主键索引,那么它一般就是二级索引。例如在 MySQL 的 InnoDB 存储引擎中,假设存在一个`employees`表: ```sql CREATE TABLE employees ( id INT PRIMARY KEY, employee_number VARCHAR(20) UNIQUE, name VARCHAR(50) ); ``` 这里`id`列上的主键索引是聚簇索引,也就是一级索引。而`employee_number`列上的唯一索引并非主键索引,它属于二级索引。二级索引的数据结构通常也是 B+ 树,它存储着索引列的值以及对应的主键值。当通过这个唯一索引进行查询时,数据库先在唯一索引的 B+ 树中找到对应的主键值,再通过主键值到聚簇索引中获取完整的数据行。 #### 2.8.2. 特殊情况 在某些特殊情况下,如果表没有定义主键,数据库可能会选择一个唯一索引作为聚簇索引。例如: ```sql CREATE TABLE products ( product_code VARCHAR(10) UNIQUE, product_name VARCHAR(50) ); ``` 若`products`表没有主键,数据库可能会将`product_code`列上的唯一索引作为聚簇索引。此时,这个唯一索引就不再是二级索引,而是起到了一级索引(主键索引)的作用。不过这种情况需要依据具体数据库的实现和配置来确定。 综上所述,在大多数常见场景下,非主键的唯一索引属于二级索引,但在表没有主键的特殊情况下,唯一索引可能会成为聚簇索引,也就不再是二级索引了。 [========] ## 3. 索引的常见模型 #### 3.1. 哈希表 索引的出现是为了提高查询效率,但是实现索引的方式却有很多种,所以这里也就引入了索引模型的概念。可以用于提高读写效率的数据结构很多,这里我先给你介绍三种常见、也比较简单的数据结构,它们分别是哈希表、有序数组和搜索树。 下面我主要从使用的角度,为你简单分析一下这三种模型的区别。 哈希表是一种以键 - 值(key-value)存储数据的结构,我们只要输入待查找的值即 key,就可以找到其对应的值即 Value。哈希的思路很简单,把值放在数组里,用一个哈希函数把 key 换算成一个确定的位置,然后把 value 放在数组的这个位置。不可避免地,多个 key 值经过哈希函数的换算,会出现同一个值的情况。处理这种情况的一种方法是,拉出一个链表。 假设,你现在维护着一个身份证信息和姓名的表,需要根据身份证号查找对应的名字,这时对应的哈希索引的示意图如下所示: 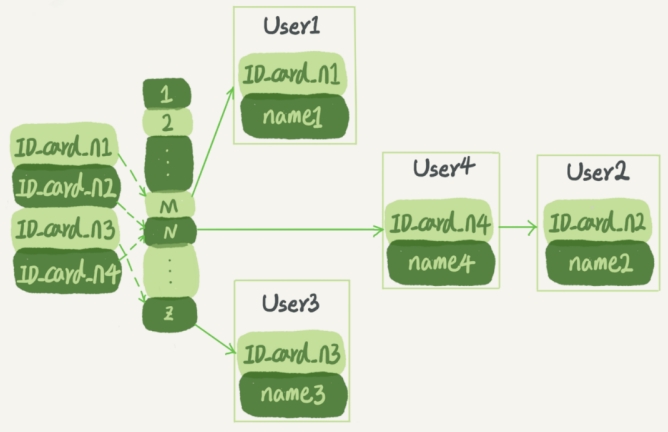 <small style="margin-left:300px">哈希表示意图</small> 图中,User2 和 User4 根据身份证号算出来的值都是 N,但没关系,后面还跟了一个链表。假设,这时候你要查ID_card_n2 对应的名字是什么,处理步骤就是:首先,将ID_card_n2 通过哈希函数算出 N;然后,按顺序遍历,找到 User2。 需要注意的是,图中四个 ID_card_n 的值并不是递增的,这样做的好处是增加新的 User时速度会很快,只需要往后追加。但缺点是,因为不是有序的,所以哈希索引做区间查询的速度是很慢的。 你可以设想下,如果你现在要找身份证号在 [ID_card_X, ID_card_Y] 这个区间的所有用户,就必须全部扫描一遍了。所以,哈希表这种结构适用于只有等值查询的场景,比如 Memcached 及其他一些NoSQL 引擎 #### 3.2. 有序数组 有序数组在等值查询和范围查询场景中的性能就都非常优秀。还是上面这个根据身份证号查名字的例子,如果我们使用有序数组来实现的话,示意图如下所示 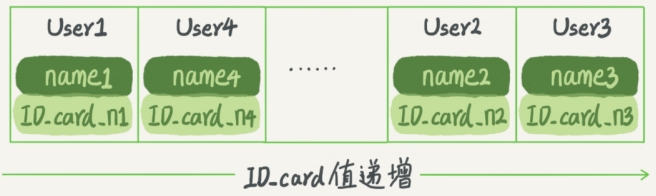 <small style="margin-left:300px">有序数组示意图</small> 这里我们假设身份证号没有重复,这个数组就是按照身份证号递增的顺序保存的。这时候如果你要查 ID_card_n2 对应的名字,用二分法就可以快速得到,这个时间复杂度是O(log(N))。 同时很显然,这个索引结构支持范围查询。你要查身份证号在 [ID_card_X, ID_card_Y] 区间的 User,可以先用二分法找到 ID_card_X(如果不存在 ID_card_X,就找到大于ID_card_X 的第一个 User),然后向右遍历,直到查到第一个大于 ID_card_Y 的身份证号,退出循环。 如果仅仅看查询效率,有序数组就是最好的数据结构了。但是,在需要更新数据的时候就麻烦了,你往中间插入一个记录就必须得挪动后面所有的记录,成本太高。 所以,有序数组索引只适用于静态存储引擎,比如你要保存的是 2017 年某个城市的所有人口信息,这类不会再修改的数据。 #### 3.3. 搜索树 二叉搜索树也是课本里的经典数据结构了。还是上面根据身份证号查名字的例子,如果我们用二叉搜索树来实现的话,示意图如下所示: 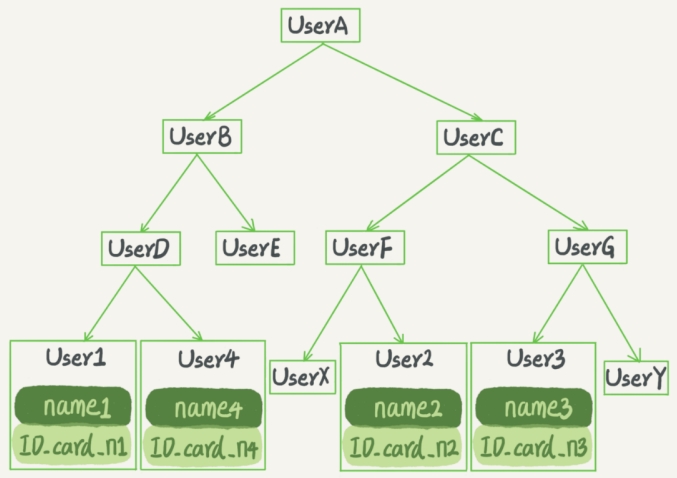 <small style="margin-left:300px">二叉搜索树示意图</small> 二叉搜索树的特点是:每个节点的左儿子小于父节点,父节点又小于右儿子。这样如果你要查 ID_card_n2 的话,按照图中的搜索顺序就是按照 UserA -> UserC -> UserF ->User2 这个路径得到。这个时间复杂度是 O(log(N))。 当然为了维持 O(log(N)) 的查询复杂度,你就需要保持这棵树是平衡二叉树。为了做这个保证,更新的时间复杂度也是 O(log(N))。 树可以有二叉,也可以有多叉。多叉树就是每个节点有多个儿子,儿子之间的大小保证从左到右递增。二叉树是搜索效率最高的,但是实际上大多数的数据库存储却并不使用二叉树。其原因是,索引不止存在内存中,还要写到磁盘上。 你可以想象一下一棵 100 万节点的平衡二叉树,树高 20。一次查询可能需要访问 20 个数据块。在机械硬盘时代,从磁盘随机读一个数据块需要 10 ms 左右的寻址时间。也就是说,对于一个 100 万行的表,如果使用二叉树来存储,单独访问一个行可能需要 20 个 10ms 的时间,这个查询可真够慢的。 为了让一个查询尽量少地读磁盘,就必须让查询过程访问尽量少的数据块。那么,我们就不应该使用二叉树,而是要使用“N 叉”树。这里,“N 叉”树中的“N”取决于数据块的大小。 以 InnoDB 的一个整数字段索引为例,这个 N 差不多是 1200。这棵树高是 4 的时候,就可以存 1200 的 3 次方个值,这已经 17 亿了。考虑到树根的数据块总是在内存中的,一个 10 亿行的表上一个整数字段的索引,查找一个值最多只需要访问 3 次磁盘。其实,树的第二层也有很大概率在内存中,那么访问磁盘的平均次数就更少了。 N 叉树由于在读写上的性能优点,以及适配磁盘的访问模式,已经被广泛应用在数据库引擎中了。 不管是哈希还是有序数组,或者 N 叉树,它们都是不断迭代、不断优化的产物或者解决方案。数据库技术发展到今天,跳表、LSM 树等数据结构也被用于引擎设计中
扫一扫手机看
点击排行
windows 文件资源管理器使用
Layui 弹窗open使用说明
SQL Server 中字符串函数使用
C# 使用QQ邮箱代理做邮件接收功能
SQL Server关于apply的两种形式cross apply 和 outer apply
ASP.NET MVC 模型的自定义验证
nvm安装及常用命令
SQL Server 中数据类型转换
SQL Server 中WITH AS短语的使用
IE浏览器下AJAX缓存问题导致数据不更新的解决办法
订阅号