切换导航
简历
工具
演示
查询
导航菜单
服务端
30
前端
114
数据库
82
进阶开发
8
桌面程序
2
QA
15
软件使用
36
规范协议
5
操作系统
11
AI
0
复用资源
6
硬件
0
标签
SQL Server
Redis
MySQL
其它
Oracle
外部链接
.NET Core SDK和运行时安装包
淘宝 NPM 镜像
查询网
Tables Generator线上表格转换工具
引用cdn在线脚本和样式
首页
数据库
MySQL 数据库介绍
[TOC] ## 1. 基础介绍 MySQL数据库是一种c/s结构的数据库系统管理软件,是一款开源免费的关系型数据库,社区版免费,企业版因为提供技术支持是收费的,适合个人/中小型企业的中型关系型数据库 ### 1.1. 交互方式 1.客户端连接认证:连接服务器,认证身份`mysql.exe -h -P -u -p` ```shell # 参数h:主机地址,P:端口,u:账户,p:密码 mysql.exe -hlocalhost -P3000 -uroot -p ``` 2.客户端发送SQL指令 3.服务器接收SQL指令,处理SQL指令,返回操作结果 4.客户端接收结果,显示结果 ```shell # 查看所有数据库 show databases ``` 5.断开连接释放资源,三种退出指令`exit` / `quit` / `\q` ```shell #退出 \q ``` ### 1.2. MySQL服务器对象 将mysql服务器内部对象分成四层:系统(DBMS)->数据库(DB)->数据表(Table)->字段(field) ### 1.3. MySQL关系说明 __数据库关系:__将实体与实体的关系,反应到数据库表的设计上,所有关系都是指的表与表之间的关系,关系主要有三种,一对一、一对多、多对多 #### 1.3.1. 一对一 一张表的一条记录可以对应另一张表的多条记录,例如人员表和人员的信息表 #### 1.3.2. 一对多 一张表的一条记录一定只能与另外一张表的一条记录进行对应 #### 1.3.3. 多对多 一张表(A)中的一条记录能够对应另外一张表(B)的多条记录,同时B表中的一条记录也能对应A表中的多条记录 > 多对多的关系,设计一般有两种方案 + 一种是在其中一张表中创建一个字段,这个字段存放着与另外一张表对应关系的字段(主键)信息,它会是一个维护多条对应表主键的拼接字符串,例如:1,2,3(使用逗号分隔的字符串) + 创建一张新表,专门用来维护两张表之间的关系,存放着两张表的主键,从而实现更加直观的多对多对应关系 ### 1.4. MySQL存储引擎 存储引擎:完成查询和文件操作等工作的功能,进行数据存储的方式,MySQL主要有两种存储引擎,innodb 和 myisam,这两种存储引擎都是免费的 __修改数据库表存储引擎语法:__<mark>alter table 表名 engine = 引擎类型;</mark> ```SQL -- 下面的命令就是将 my_student 表的存储引擎修改为 innodb alter table my_student engine = innodb; ``` __查看MySQL支持的存储引擎种类__ ```SQL show engines; ``` 下面是查询 MySQL 8.0.32 的结果 | Engine| Support | Comment| Transactions | XA | Savepoints | |--|--|--|--|--|--| | MEMORY| YES| Hash based, stored in memory, useful for temporary tables| NO| NO| NO| | MRG_MYISAM| YES| Collection of identical MyISAM tables| NO| NO | NO| | CSV| YES| CSV storage engine| NO| NO | NO| | FEDERATED| NO| Federated MySQL storage engine| NULL| NULL | NULL| | PERFORMANCE_SCHEMA | YES| Performance Schema| NO| NO| NO| | MyISAM| YES| MyISAM storage engine| NO| NO| NO| | InnoDB| DEFAULT | Supports transactions, row-level locking, and foreign keys| YES| YES| YES| | ndbinfo| NO| MySQL Cluster system information storage engine| NULL| NULL | NULL | | BLACKHOLE| YES| /dev/null storage engine (anything you write to it disappears) | NO| NO| NO| | ARCHIVE| YES| Archive storage engine| NO| NO| NO| | ndbcluster| NO| Clustered, fault-tolerant tables| NULL| NULL| NULL| __innodb 存储引擎与 myisam 存储引擎对比:__ |对比向|innodb|myisam| |--|--| |存储方式|表结构,数据,索引全部存储到ibdata1文件中|表,数据,索引全部单独分开存储| |存储文件|以 innodb 存储引擎创建的表,在数据库文件夹中只会有一个frm文件,里面包含了表结构,数据,索引信息|以 myisam 存储引擎创建的表,在数据库文件夹中会有一个frm文件存储表结构,MYD文件存储数据,MYI文件存放索引| |数据表备份|使用 innodb 存储引擎创建的表,如果使用数据表备份,将frm文件复制到其它的库,`show tables` 可以查到,但 `select` 查询数据时会报错 <mark>ERROR 1146 <32S02>:Table 'my_student' dossn't exist</mark>,这是因为 innodb 存储引擎创建的表对数据有依赖|使用 myisam 存储引擎创建的表,如果使用数据表备份,将frm、MYD、MYI文件复制到其它的库,`show tables` 可以查到,`select` 也可以查询到数据| __支持MySQL数据库的存储引擎对比__ |对比项|Myisam|Innodb|BDB|Memory|Archive|blackhole|csv| |--|--|--|--|--|--|--|--| |批量插入的速度|高|低|高|高|非常高||| |事务安全||支持|支持||||| |全文索引|支持|支持|||||| |锁机制|表锁|行锁|页锁|表锁|行锁||| |存储限制|没有|64TB|没有|有|没有||| |B树索引|支持|支持|支持|支持|||| |哈希索引||支持||支持|||| |集群索引||支持|||||| |数据缓存||支持||支持|||| |索引缓存|支持|支持||支持|||| |数据可压缩|支持||||支持||| |空间使用|低|高|低|N/A|非常低||| |内存使用|低|高|低|中等|低||| |支持外键||支持||||| | __存储引擎说明__ + blackhole,写入任何数据都会消失,查询始终为空,用于复制 + csv,将数据保存为csv格式文件,excel可打开 ## 2. MySQL 基本架构 ### 2.1. 架构示意图 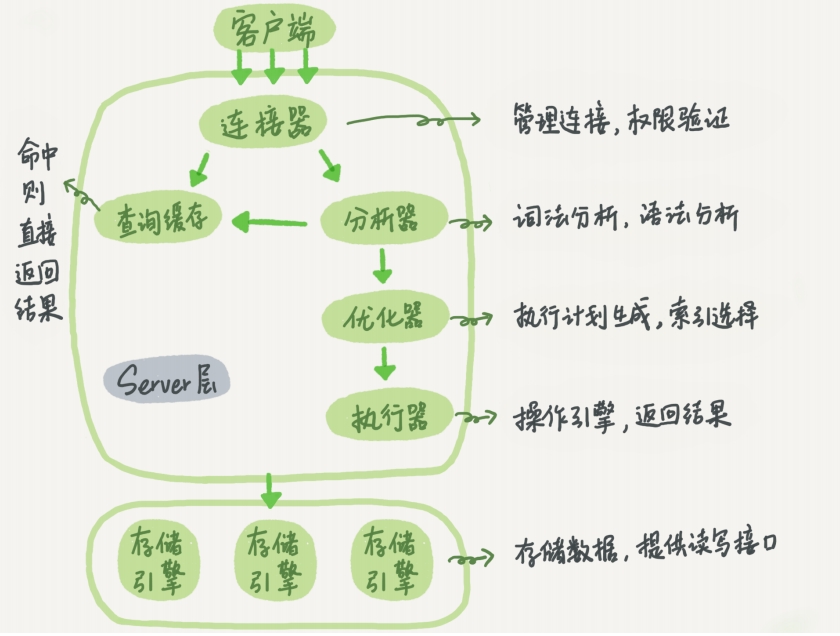 ### 2.2. Server 层 **Server 层:**包括连接器、查询缓存、分析器、优化器、执行器等,涵盖 MySQL 的大多数核心服务功能,以及所有的内置函数(如日期、时间、数学和加密函数等),所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图等 #### 2.2.1. 连接器 第一步,你会先连接到这个数据库上,这时候接待你的就是连接器。连接器负责跟客户端建立连接、获取权限、维持和管理连接。连接命令一般是这么写的 ```bash mysql -h$ip -P$port -u$user -p ``` 输完命令之后,你就需要在交互对话里面输入密码。虽然密码也可以直接跟在 -p 后面写在命令行中,但这样可能会导致你的密码泄露。如果你连的是生产服务器,强烈建议你不要这么做 连接命令中的 mysql 是客户端工具,用来跟服务端建立连接。在完成经典的 TCP 握手后,连接器就要开始认证你的身份,这个时候用的就是你输入的用户名和密码 如果用户名或密码不对,你就会收到一个"Access denied for user"的错误,然后客户端程序结束执行。 如果用户名密码认证通过,连接器会到权限表里面查出你拥有的权限。之后,这个连接里面的权限判断逻辑,都将依赖于此时读到的权限。这就意味着,一个用户成功建立连接后,即使你用管理员账号对这个用户的权限做了修 改,也不会影响已经存在连接的权限。修改完成后,只有再新建的连接才会使用新的权限设置 连接完成后,如果你没有后续的动作,这个连接就处于空闲状态,你可以在 `show processlist` 命令中看到它。 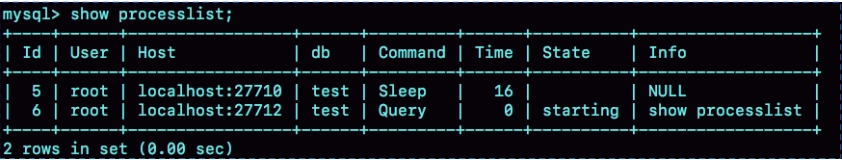 文本中这个图是 show processlist 的结果,其中的Command 列显示为“Sleep”的这一行,就表示现在系统里面有一个空闲连接 客户端如果太长时间没动静,连接器就会自动将它断开。这个时间是由参数 wait_timeout 控制的,默认值是 8 小时 如果在连接被断开之后,客户端再次发送请求的话,就会收到一个错误提醒: Lost connection to MySQL server during query。这时候如果你要继续,就需要重连,然后再执行请求了。 数据库里面,长连接是指连接成功后,如果客户端持续有请求,则一直使用同一个连接。短连接则是指每次执行完很少的几次查询就断开连接,下次查询再重新建立一个。建立连接的过程通常是比较复杂的,所以我建议你在使用中要尽量减少建立连接的动作,也就是尽量使用长连接。但是全部使用长连接后,你可能会发现,有些时候 MySQL 占用内存涨得特别快,这是因为 MySQL 在执行过程中临时使用的内存是管理在连接对象里面的。这些资源会在连接断开的时候才释放。所以如果长连接累积下来,可能导致内存占用太大,被系统强行杀掉(OOM),从现象看就是 MySQL 异常重启了。 怎么解决这个问题呢?你可以考虑以下两种方案。 1. 定期断开长连接。使用一段时间,或者程序里面判断执行过一个占用内存的大查询后,断开连接,之后要查询再重连。 2. 如果你用的是 MySQL 5.7 或更新版本,可以在每次执行一个比较大的操作后,通过执行 mysql_reset_connection 来重新初始化连接资源。这个过程不需要重连和重新做权限验证,但是会将连接恢复到刚刚创建完时的状态 #### 2.2.2. 查询缓存 连接建立完成后,你就可以执行 select 语句了。执行逻辑就会来到第二步:查询缓存。MySQL 拿到一个查询请求后,会先到查询缓存看看,之前是不是执行过这条语句。之前执行过的语句及其结果可能会以 key-value 对的形式,被直接缓存在内存中。key 是查询的语句,value 是查询的结果。如果你的查询能够直接在这个缓存中找到 key,那么这个value 就会被直接返回给客户端。如果语句不在查询缓存中,就会继续后面的执行阶段。执行完成后,执行结果会被存入查询缓存中。你可以看到,如果查询命中缓存,MySQL 不需要执行后面的复杂操作,就可以直接返回结果,这个效率会很高。 **但是大多数情况下我会建议你不要使用查询缓存,为什么呢?因为查询缓存往往弊大于利** 查询缓存的失效非常频繁,只要有对一个表的更新,这个表上所有的查询缓存都会被清空。因此很可能你费劲地把结果存起来,还没使用呢,就被一个更新全清空了。对于更新压力大的数据库来说,查询缓存的命中率会非常低。除非你的业务就是有一张静态表,很长时间才会更新一次。比如,一个系统配置表,那这张表上的查询才适合使用查询缓存。好在 MySQL 也提供了这种“按需使用”的方式。你可以将参数 query_cache_type 设置成 DEMAND,这样对于默认的 SQL 语句都不使用查询缓存。而对于你确定要使用查询缓存的语句,可以用 SQL_CACHE 显式指定,像下面这个语句一样: ```sql mysql> select SQL_CACHE * from T where ID=10; ``` >** Tips:**需要注意的是,MySQL 8.0 版本直接将查询缓存的整块功能删掉了,也就是说 8.0 开始彻底没有这个功能了 #### 2.2.3. 分析器 如果没有命中查询缓存,就要开始真正执行语句了。首先,MySQL 需要知道你要做什么,因此需要对 SQL 语句做解析。分析器先会做`“词法分析”`。你输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面的字符串分别是什么,代表什么。 MySQL 从你输入的"select"这个关键字识别出来,这是一个查询语句。它也要把字符串“T”识别成“表名 T”,把字符串“ID”识别成“列 ID”。 做完了这些识别以后,就要做`“语法分析”`。根据词法分析的结果,语法分析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法 如果你的语句不对,就会收到“You have an error in your SQL syntax”的错误提醒,比如下面这个语句 select 少打了开头的字母“s”。 ```SQL mysql> elect * from t where ID=1; -- ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that correspo…… ``` 一般语法错误会提示第一个出现错误的位置,所以你要关注的是紧接“use near”的内容 #### 2.2.4. 优化器 经过了分析器,MySQL 就知道你要做什么了。在开始执行之前,还要先经过优化器的处理。 优化器是在表里面有多个索引的时候,决定使用哪个索引;或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序。比如你执行下面这样的语句,这个语句是执行两个表的 join: ```SQL mysql> select * from t1 join t2 using(ID) where t1.c=10 and t2.d=20; ``` 既可以先从表 t1 里面取出 c=10 的记录的 ID 值,再根据 ID 值关联到表 t2,再判断 t2里面 d 的值是否等于 20。也可以先从表 t2 里面取出 d=20 的记录的 ID 值,再根据 ID 值关联到 t1,再判断 t1里面 c 的值是否等于 10。这两种执行方法的逻辑结果是一样的,但是执行的效率会有不同,而优化器的作用就是决定选择使用哪一个方案。 优化器阶段完成后,这个语句的执行方案就确定下来了,然后进入执行器阶段。 > **疑问:**优化器是怎么选择索引的,有没有可能选择错等等? #### 2.2.4. 执行器 MySQL 通过分析器知道了你要做什么,通过优化器知道了该怎么做,于是就进入了执行器阶段,开始执行语句。 开始执行的时候,要先判断一下你对这个表 T 有没有执行查询的权限,如果没有,就会返回没有权限的错误,如下所示 (在工程实现上,如果命中查询缓存,会在查询缓存返回结果的时候,做权限验证。查询也会在优化器之前调用 precheck 验证权限)。 ```SQL mysql> select * from T where ID=10; -- ERROR 1142 (42000): SELECT command denied to user 'b'@'localhost' for table 'T' ``` 如果有权限,就打开表继续执行。打开表的时候,执行器就会根据表的引擎定义,去使用这个引擎提供的接口。比如我们这个例子中的表 T 中,ID 字段没有索引,那么执行器的执行流程是这样的: 1. 调用 InnoDB 引擎接口取这个表的第一行,判断 ID 值是不是 10,如果不是则跳过,如果是则将这行存在结果集中; 2. 调用引擎接口取“下一行”,重复相同的判断逻辑,直到取到这个表的最后一行。 3. 执行器将上述遍历过程中所有满足条件的行组成的记录集作为结果集返回给客户端。 至此,这个语句就执行完成了。 对于有索引的表,执行的逻辑也差不多。第一次调用的是“取满足条件的第一行”这个接口,之后循环取“满足条件的下一行”这个接口,这些接口都是引擎中已经定义好的。 你会在数据库的慢查询日志中看到一个 rows_examined 的字段,表示这个语句执行过程中扫描了多少行。这个值就是在执行器每次调用引擎获取数据行的时候累加的。 ```sql SHOW STATUS LIKE 'Rows_examined'; ``` > rows_examined定义:rows_examined 表明存储引擎在执行查询时扫描的行数。不管这些行是否符合查询的过滤条件,只要存储引擎对其进行了检查,就会计入 rows_examined 在有些场景下,执行器调用一次,在引擎内部则扫描了多行,因此引擎扫描行数跟rows_examined 并不是完全相同的,例如:在进行多表连接查询时,rows_examined 统计的是所有参与连接的表中被存储引擎扫描的行数总和。要是你单独分析某个表的引擎扫描行数,和 rows_examined 的总值就可能不同。但对于单表查询,二者基本是一致的 > **疑问:**存储引擎的内部机制? ### 2.3. 存储引擎层 **存储引擎层:**负责数据的存储和提取。其架构模式是插件式的,支持 InnoDB、MyISAM、Memory 等多个存储引擎。现在最常用的存储引擎是 InnoDB,它从 MySQL 5.5.5 版本开始成为了默认存储引擎 ## 3. MySQL中SQL更新语句执行过程 更新语句同样需要走查询语句执行的过程,连接器 》分析器 》 优化器 》 执行器,与查询流程不一样的是,更新流程还涉及两个重要的日志模块:redo log(物理日志)和 binlog(逻辑日志) ### 3.1. 物理日志:redo log 不知道你还记不记得《孔乙己》这篇文章,酒店掌柜有一个粉板,专门用来记录客人的赊账记录。如果赊账的人不多,那么他可以把顾客名和账目写在板上。但如果赊账的人多了,粉板总会有记不下的时候,这个时候掌柜一定还有一个专门记录赊账的账本。 如果有人要赊账或者还账的话,掌柜一般有两种做法: + 一种做法是直接把账本翻出来,把这次赊的账加上去或者扣除掉; + 另一种做法是先在粉板上记下这次的账,等打烊以后再把账本翻出来核算。 在生意红火柜台很忙时,掌柜一定会选择后者,因为前者操作实在是太麻烦了。首先,你得找到这个人的赊账总额那条记录。你想想,密密麻麻几十页,掌柜要找到那个名字,可能还得带上老花镜慢慢找,找到之后再拿出算盘计算,最后再将结果写回到账本上。 这整个过程想想都麻烦。相比之下,还是先在粉板上记一下方便。你想想,如果掌柜没有粉板的帮助,每次记账都得翻账本,效率是不是低得让人难以忍受? 同样,在 MySQL 里也有这个问题,如果每一次的更新操作都需要写进磁盘,然后磁盘也要找到对应的那条记录,然后再更新,整个过程 IO 成本、查找成本都很高。为了解决这个问题,MySQL 的设计者就用了类似酒店掌柜粉板的思路来提升更新效率。 而粉板和账本配合的整个过程,其实就是 MySQL 里经常说到的 WAL 技术,WAL 的全称是 Write-Ahead Logging,它的关键点就是先写日志,再写磁盘,也就是先写粉板,等不忙的时候再写账本。 具体来说,当有一条记录需要更新的时候,InnoDB 引擎就会先把记录写到 redo log(粉板)里面,并更新内存,这个时候更新就算完成了。同时,InnoDB 引擎会在适当的时候,将这个操作记录更新到磁盘里面,而这个更新往往是在系统比较空闲的时候做,这就像打烊以后掌柜做的事。 如果今天赊账的不多,掌柜可以等打烊后再整理。但如果某天赊账的特别多,粉板写满了,又怎么办呢?这个时候掌柜只好放下手中的活儿,把粉板中的一部分赊账记录更新到账本中,然后把这些记录从粉板上擦掉,为记新账腾出空间。 与此类似,InnoDB 的 redo log 是固定大小的,比如可以配置为一组 4 个文件,每个文件的大小是 1GB,那么这块“粉板”总共就可以记录 4GB 的操作。从头开始写,写到末尾就又回到开头循环写,如下面这个图所示。 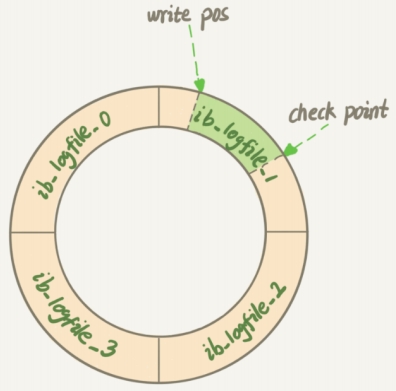 write pos 是当前记录的位置,一边写一边后移,写到第 3 号文件末尾后就回到 0 号文件开头。checkpoint 是当前要擦除的位置,也是往后推移并且循环的,擦除记录前要把记录更新到数据文件。 write pos 和 checkpoint 之间的是“粉板”上还空着的部分,可以用来记录新的操作。如果 write pos 追上 checkpoint,表示“粉板”满了,这时候不能再执行新的更新,得停下来先擦掉一些记录,把 checkpoint 推进一下。 有了 redo log,InnoDB 就可以保证即使数据库发生异常重启,之前提交的记录都不会丢失,这个能力称为crash-safe。 要理解 crash-safe 这个概念,可以想想我们前面赊账记录的例子。只要赊账记录记在了粉板上或写在了账本上,之后即使掌柜忘记了,比如突然停业几天,恢复生意后依然可以通过账本和粉板上的数据明确赊账账目。 ### 3.2. 逻辑日志:binlog 前面我们讲过,MySQL 整体来看,其实就有两块:一块是 Server 层,它主要做的是MySQL 功能层面的事情;还有一块是引擎层,负责存储相关的具体事宜。上面我们聊到的粉板 redo log 是 InnoDB 引擎特有的日志,而 Server 层也有自己的日志,称为binlog(归档日志)。 **我想你肯定会问,为什么会有两份日志呢?** 因为最开始 MySQL 里并没有 InnoDB 引擎。MySQL 自带的引擎是 MyISAM,但是MyISAM 没有 crash-safe 的能力,binlog 日志只能用于归档。而 InnoDB 是另一个公司以插件形式引入 MySQL 的,既然只依靠 binlog 是没有 crash-safe 能力的,所以InnoDB 使用另外一套日志系统——也就是 redo log 来实现 crash-safe 能力。 **这两种日志有以下三点不同。** + redo log 是 InnoDB 引擎特有的;binlog 是 MySQL 的 Server 层实现的,所有引擎都可以使用。 + redo log 是物理日志,记录的是“在某个数据页上做了什么修改”;binlog 是逻辑日志,记录的是这个语句的原始逻辑,比如“给 ID=2 这一行的 c 字段加 1 ”。 + redo log 是循环写的,空间固定会用完;binlog 是可以追加写入的。“追加写”是指binlog 文件写到一定大小后会切换到下一个,并不会覆盖以前的日志。 有了对这两个日志的概念性理解,我们再来看执行器和 InnoDB 引擎在执行这个简单的update 语句时的内部流程。 1. 执行器先找引擎取 ID=2 这一行。ID 是主键,引擎直接用树搜索找到这一行。如果ID=2 这一行所在的数据页本来就在内存中,就直接返回给执行器;否则,需要先从磁盘读入内存,然后再返回。 2. 执行器拿到引擎给的行数据,把这个值加上 1,比如原来是 N,现在就是 N+1,得到新的一行数据,再调用引擎接口写入这行新数据。 3. 引擎将这行新数据更新到内存中,同时将这个更新操作记录到 redo log 里面,此时redo log 处于 prepare(筹备) 状态。然后告知执行器执行完成了,随时可以提交事务。 4. 执行器生成这个操作的 binlog,并把 binlog 写入磁盘。 5. 执行器调用引擎的提交事务接口,引擎把刚刚写入的 redo log 改成提交(commit)状态,更新完成。 这里我给出这个 update 语句的执行流程图,图中浅色框表示是在 InnoDB 内部执行的,深色框表示是在执行器中执行的。 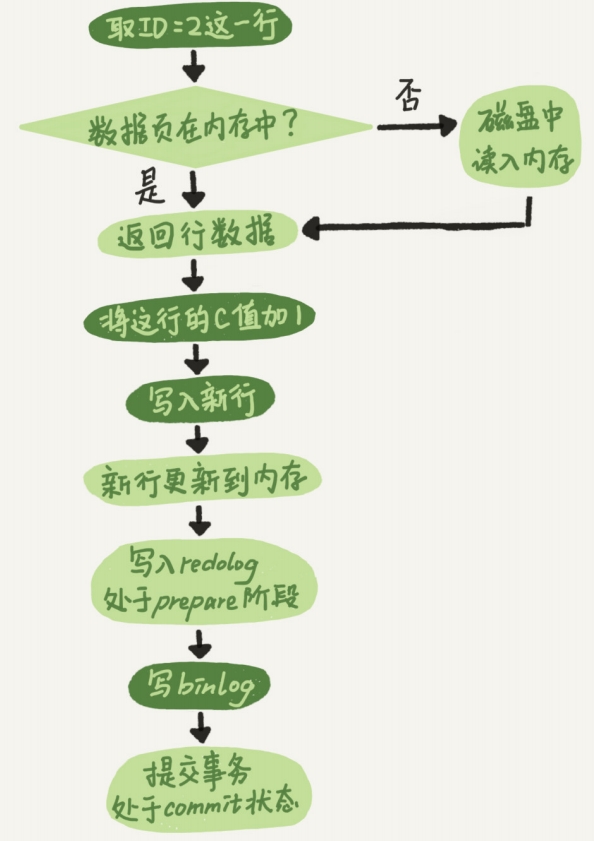 你可能注意到了,最后三步看上去有点“绕”,将 redo log 的写入拆成了两个步骤:prepare 和 commit,这就是"两阶段提交"。 > 备注:Binlog有两种模式,statement 格式的话是记sql语句, row格式会记录行的内容,记两条,更新前和更新后都有。 ### 3.3. 两阶段提交 为什么必须有“两阶段提交”呢?这是为了让两份日志之间的逻辑一致。要说明这个问题,我们得从文章开头的那个问题说起:怎样让数据库恢复到半个月内任意一秒的状态? 前面我们说过了,binlog 会记录所有的逻辑操作,并且是采用“追加写”的形式。如果你的 DBA 承诺说半个月内可以恢复,那么备份系统中一定会保存最近半个月的所有binlog,同时系统会定期做整库备份。这里的“定期”取决于系统的重要性,可以是一天一备,也可以是一周一备。 当需要恢复到指定的某一秒时,比如某天下午两点发现中午十二点有一次误删表,需要找回数据,那你可以这么做: > 首先,找到最近的一次全量备份,如果你运气好,可能就是昨天晚上的一个备份,从这个备份恢复到临时库; 然后,从备份的时间点开始,将备份的 binlog 依次取出来,重放到中午误删表之前的那个时刻。 这样你的临时库就跟误删之前的线上库一样了,然后你可以把表数据从临时库取出来,按需要恢复到线上库去。 好了,说完了数据恢复过程,我们回来说说,为什么日志需要“两阶段提交”。这里不妨用反证法来进行解释。 由于 redo log 和 binlog 是两个独立的逻辑,如果不用两阶段提交,要么就是先写完redo log 再写 binlog,或者采用反过来的顺序。我们看看这两种方式会有什么问题。 仍然用前面的 update 语句来做例子。假设当前 ID=2 的行,字段 c 的值是 0,再假设执行 update 语句过程中在写完第一个日志后,第二个日志还没有写完期间发生了 crash,会出现什么情况呢? + **先写 redo log 后写 binlog** 假设在 redo log 写完,binlog 还没有写完的时候,MySQL 进程异常重启。由于我们前面说过的,redo log 写完之后,系统即使崩溃,仍然能够把数据恢复回来,所以恢复后这一行 c 的值是 1。 但是由于 binlog 没写完就 crash 了,这时候 binlog 里面就没有记录这个语句。因此,之后备份日志的时候,存起来的 binlog 里面就没有这条语句。 然后你会发现,如果需要用这个 binlog 来恢复临时库的话,由于这个语句的 binlog 丢失,这个临时库就会少了这一次更新,恢复出来的这一行 c 的值就是 0,与原库的值不同。 + **先写 binlog 后写 redo log** 如果在 binlog 写完之后 crash,由于 redo log 还没写,崩溃恢复以后这个事务无效,所以这一行 c 的值是 0。但是 binlog 里面已经记录了“把 c 从 0 改成 1”这个日志。所以,在之后用 binlog 来恢复的时候就多了一个事务出来,恢复出来的这一行 c 的值就是 1,与原库的值不同。 可以看到,如果不使用“两阶段提交”,那么数据库的状态就有可能和用它的日志恢复出来的库的状态不一致。 你可能会说,这个概率是不是很低,平时也没有什么动不动就需要恢复临时库的场景呀? 其实不是的,不只是误操作后需要用这个过程来恢复数据。当你需要扩容的时候,也就是需要再多搭建一些备库来增加系统的读能力的时候,现在常见的做法也是用全量备份加上应用 binlog 来实现的,这个“不一致”就会导致你的线上出现主从数据库不一致的情况。 简单说,redo log 和 binlog 都可以用于表示事务的提交状态,而两阶段提交就是让这两个状态保持逻辑上的一致。 > **总结:** > redo log 用于保证 crash-safe 能力。innodb_flush_log_at_trx_commit 这个参数设置成1 的时候,表示每次事务的 redo log 都直接持久化到磁盘。这个参数我建议你设置成 1,这样可以保证 MySQL 异常重启之后数据不丢失。 > sync_binlog 这个参数设置成 1 的时候,表示每次事务的 binlog 都持久化到磁盘。这个参数我也建议你设置成 1,这样可以保证 MySQL 异常重启之后 binlog 不丢失。 > 我还跟你介绍了与 MySQL 日志系统密切相关的“两阶段提交”。两阶段提交是跨系统维持数据逻辑一致性时常用的一个方案,即使你不做数据库内核开发,日常开发中也有可能会用到。
扫一扫手机看
点击排行
windows 文件资源管理器使用
Layui 弹窗open使用说明
SQL Server 中字符串函数使用
C# 使用QQ邮箱代理做邮件接收功能
SQL Server关于apply的两种形式cross apply 和 outer apply
ASP.NET MVC 模型的自定义验证
nvm安装及常用命令
SQL Server 中数据类型转换
SQL Server 中WITH AS短语的使用
IE浏览器下AJAX缓存问题导致数据不更新的解决办法
订阅号